
작게 끊으면 넓어지고, 자주 찍으면 좁아진다: 양자화 오차와 교집합의 수학
-

- 2026.11.08 - 08:49 2026.11.07 - 14:18 151 1
우리는 뭔가를 잴 때, 측정기가 진짜값을 보여준다고 믿고 싶어한다. 그런데 대부분의 측정기는 진짜값을 그대로 보여주지 않는다. 반올림하거나 버려서 보여준다.
주방 저울이 1g 단위라면, 진짜 10.4g도 10g으로 보인다. 게임에서 경험치가 소수점 4자리까지만 보인다면, 진짜 0.12345%도 0.1234%로 보인다. 이 차이가 양자화 오차(quantization error)다.
확률 오차가 아니다. 매번 랜덤으로 틀리는 게 아니다. 보여주는 단위 때문에 생기는, 확정적인 오차다.
이 글은 "많이 모으면 정확해진다"는 상식이 왜 양자화 오차 앞에서는 통하지 않는지, 그리고 어떻게 재야 가장 정확한지를 수식으로 정리한 글이다. 마지막에는 많이 모으는 게 오히려 도움이 되는 경우, 교집합에 대해서도 다룬다.
1. 모델: 진짜값과 관측값
진짜 누적값을 `T`, 측정기가 보여주는 최소 단위를 `Δ`라고 하자. 예를 들어 경험치 %를 소수점 4자리까지 보여준다면 `Δ = 0.0001%`다.
관측값은 두 가지 방식 중 하나다.
오차 ε = 관측 - T, ε ∈ [-Δ/2, +Δ/2]
버림(내림): 관측 = floor(T / Δ) * Δ
진짜값 T ∈ [관측, 관측 + Δ)
어느 방식인지가 중요하다. 실제 게임 경험치 실험에서 반올림으로 가정하고 51개 누적점의 구간을 교집합했더니, 교집합이 빈 집합이 됐다. 최대 하한이 최소 상한보다 커져서 진짜값이 들어갈 곳이 없어진 거다. 버림으로 계산하면 51개 구간이 전부 겹쳐서 진짜값을 포함한다. 이 게임의 % 표시는 반올림이 아니라 버림이다.
이 글에서는 아래부터 버림을 기준으로 쓴다. 최악 오차의 크기는 반올림과 같지만, 구간의 모양이 한쪽으로 치우쳐 있다.
한 구간을 잴 때는 시작과 끝을 각각 재서 빼야 한다.
진짜 Δ ∈ [Δ_obs - Δ, Δ_obs + Δ]
한 구간의 오차는 최대 `±Δ`다. 시작과 끝에서 각각 최대 `Δ`만큼 버려지기 때문이다.
여기서부터가 중요하다. 구간이 `m`개로 끊기면, 총합의 오차는 각 구간의 오차를 합친 것이 된다.
2. 최악 오차: 100% 구간
버림이 최악으로 다 같은 방향으로 틀어졌다고 가정하면, 총 오차는
즉, 구간 개수에 비례해서 커진다. 총합을 `T`라고 하면, 상대오차는
핵심은 총합 `T`가 아니라 평균 구간 길이 `T/m`이다. 총합이 커져도, 구간 개수가 더 빨리 늘어나면 오차는 커진다.
예시를 들어 보자.
측정 최소 단위가 Δ = 0.0001%라고 하자.
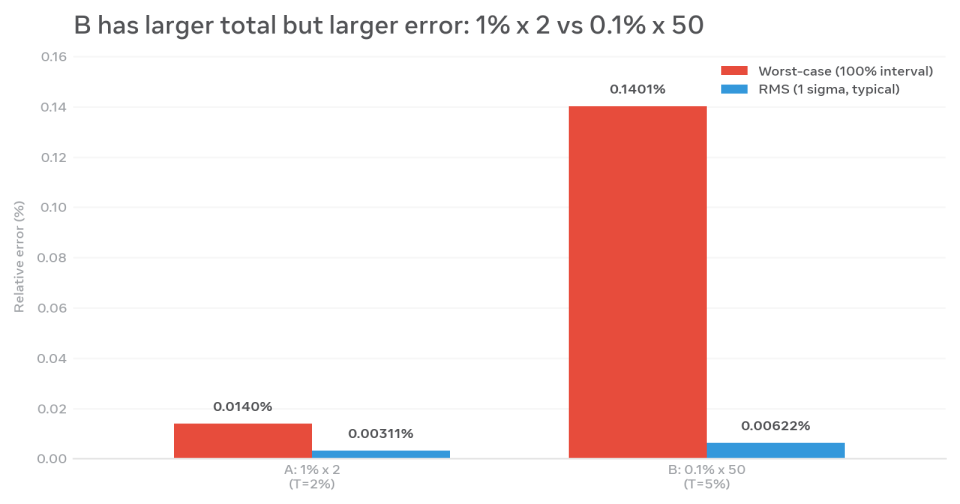
- A: 1% 구간 2개 → 총합 2%, 구간 수 2, 최악 오차 ±0.0002%p, 상대오차 0.0140%
- B: 0.1% 구간 50개 → 총합 5%, 구간 수 50, 최악 오차 ±0.005%p, 상대오차 0.1401%
B는 총합이 2.5배 더 큰데도, 최악 오차는 10배 더 나쁘다. 신호는 2.5배 늘었는데, 버림 횟수는 25배 늘었기 때문이다.
3. 평균 오차: RMS, 왜 확률처럼 될까?
최악은 "운이 최악일 때"다. 실제로는 버림 오차가 매번 같은 방향으로 틀어지진 않는다. 각 구간의 시작점에서의 소수점 이하 부분이 사실상 랜덤하게 보이기 때문에, 많은 구간을 합치면 오차가 확률처럼 행동한다.
각 버림 오차를 균등분포 `U(0, Δ)`로 보면, 분산은 `Δ²/12`다. 한 구간의 오차는 두 개를 뺀 거라 분산은 `Δ²/6`이다. `m`개 구간을 합치면
표준편차(RMS) = Δ * √(m/6)
상대오차(RMS) ≈ √(m/6) / T
이게 바로 중심극한정리다. 구간이 많아지면 양자화 오차의 합이 가우시안으로 수렴한다. 그래서 양자화 실험도, 구간을 잘게 쪼개면 결국 확률 실험처럼 `1/√m` 스케일이 되어버린다.
같은 예시로 계산하면:
* B: RMS 상대오차 0.00622%
총합이 더 큰 B가 RMS 기준으로도 2배 더 나쁘다.
4. 섞으면 어떻게 될까? - 끊긴 구간을 추가하는 경우
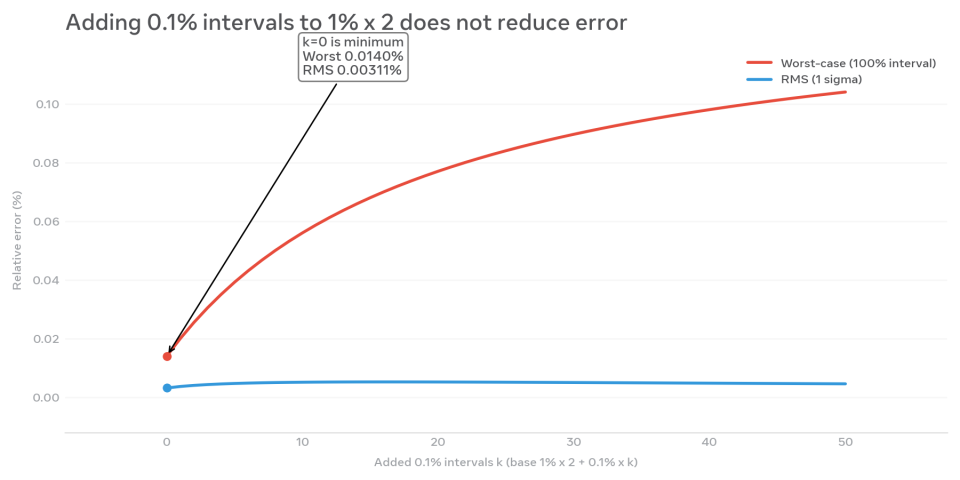
`1% × 2개`에 `0.1% × k개`를 섞는 경우를 보자. 총합 `T = 2% + 0.1%*k`, 구간수 `m = 2 + k`다. 여기서 섞는다는 건 따로 끊긴 구간을 추가한다는 뜻이다.
| 추가한 0.1% 구간 수 k | 총합 | 최악 | RMS |
| 0 | 2.00% | 0.01% | 0.00% |
| 1 | 2.10% | 0.02% | 0.00% |
| 5 | 2.50% | 0.04% | 0.00% |
| 10 | 3.00% | 0.06% | 0.01% |
| 16 | 3.60% | 0.07% | 0.00518% (최대) |
| 30 | 5.00% | 0.09% | 0.00% |
| 50 | 7.00% | 0.10% | 0.00% |
최악은 단조 증가, RMS는 k=16에서 최대를 찍고 천천히 내려가도 k=0보다 절대 좋아지지 않는다.
왜 그럴까? 새 구간 `s`를 추가하면 `m → m+1`, `T → T+s`가 된다.
* RMS가 좋아지는 조건: `√(m+1)/(T+s) < √m/T` → `s > T*(√(1+1/m)-1)` ≈ `T/(2m)`
즉, 끊긴 구간을 새로 추가할 때, 새 구간이 기존 평균보다 작으면 최악도 RMS도 둘 다 나빠진다. 새 구간이 평균보다 크면 최악은 유지되고 RMS는 좋아진다.
작은 구간 `s=0.1%`는 신호는 0.1%만 가져오는데, 노이즈 분산은 `+1/6`을 가져온다. 큰 구간 `s=1%`는 신호는 1%를 가져오는데, 노이즈 분산은 똑같이 `+1/6`이다. 작은 구간은 "오차 대비 신호"가 10배 나쁘다. 그래서 끊긴 작은 구간을 섞는다고 무조건 좋아지지 않는다.
5. 교집합: 연속 세션 안의 중간 체크는 다르다
여기까지 읽으면 "작은 데이터는 버려라, 중간 체크는 보험용으로만 찍어라"로 이해하기 쉽다. 그런데 연속 세션 안의 중간 체크는 완전히 다르다.
끊긴 구간은 시작 오차가 새로 생긴다. 그래서 구간 수 `m`이 늘어나고 오차가 쌓인다. 하지만 연속 세션에서는 시작점이 같다. 각 중간 체크점은 모두 같은 상수에 대한 제약이다.
예를 들어 두 캐릭터가 같이 경험치를 먹을 때, 두 누적 %의 비율로 추정하려는 Need 비율은 처음부터 끝까지 같은 상수다. 각 체크점마다 버림 구간을 하나씩 얻을 수 있다.
진짜값은 이 구간 전부 안에 있어야 한다.
그래서 각 구간의 교집합을 구하면 범위가 좁아진다. 단독으로는 폭이 넓은 작은 점도, 한쪽을 자르는 가위 역할을 한다.
실제 실험에서 0.56%까지 누적한 51개 점으로 해보면:
* 51개 전부 교집합: 폭 3,177 (5.5배 좁아짐)
최종점이 최소 쪽을 결정하고, 중간에 있던 한 점이 최대 쪽을 잘라낸 덕분이다. 작은 점 하나하나가 다 쓸모가 있었던 거다.
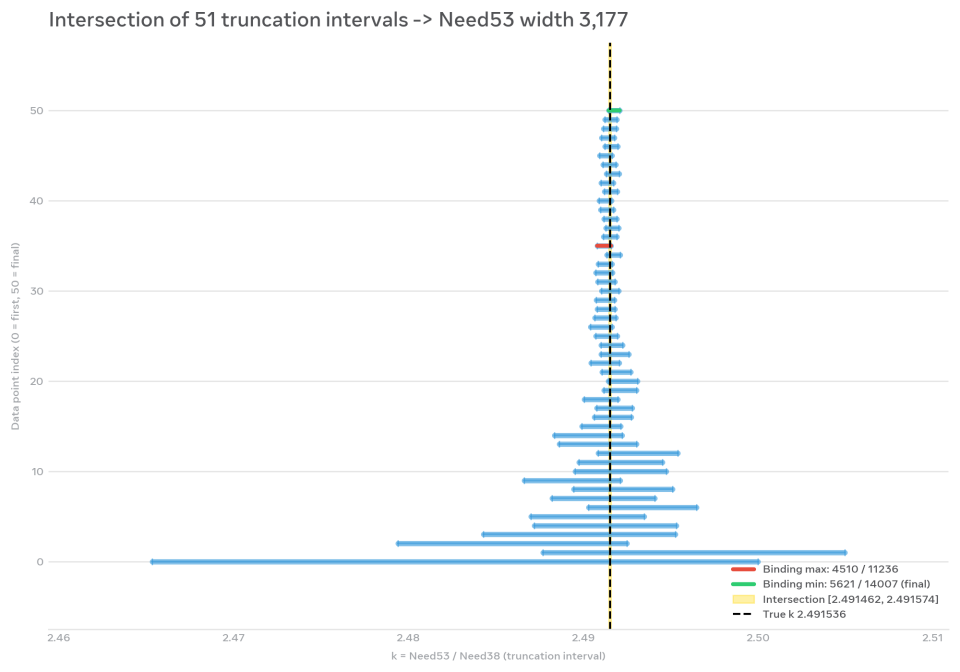
[그림 3: 51개 구간의 교집합]
정리하면 이렇게 나눠야 한다.
* 연속 세션 + 중간 체크 많이 = 교집합으로 좁아져서 이득
중간 체크는 보험이 아니라, 정밀도를 높이는 본질적인 데이터다. 연속 세션에서는 최대한 자주, 세세하게 찍는 게 정답이다.
6. 확률 실험과 양자화 실험의 차이
우리가 일상적으로 하는 실험은 많은 경우 확률 실험이다.
* 오차는 `1/√N`으로 줄어든다. 10배 정확해지려면 100배 더 해야 한다.
* 95% CI는 "100번 반복하면 95번 포함"이라는 확률적 의미다.
양자화 실험은 다르다.
* 오차는 `1/N`으로 줄어든다. 10배 정확해지려면 10배만 더 쌓으면 된다.
* 100% 구간이 정확하다. 총합 ± mΔ는 100% 진짜값을 포함한다.
그래서 양자화 실험에 95% CI를 쓰는 건 편의상 빌려온 거고, 엄밀히는 100% 구간이 맞다. 그리고 누적된 점들을 독립이라고 보고 SE를 계산하면 오차를 과소평가한다. 구간별 Δ끼리 합치는 게 맞는 통계다. 단, 같은 상수를 재는 연속 체크점들은 교집합으로 다뤄야 한다.
7. 현실에서 자주 만나는 경우
* 주방 저울: 1g 단위 저울로 10g씩 50번 재는 것보다 500g 한 번 재는 게 정확하다. 0.1g 저울이 비싼 이유가 이거다.
* 주유소 / 전기: 펌프 0.01L, 계량기 0.1kWh. 연비 재려면 조금씩 여러 번 넣지 말고 한 번에 많이 넣어야 한다.
* 금융: 주식 호가 1원, 환전 반올림. 소액 여러 번 거래하면 반올림 비용이 쌓인다.
* 센서: 온도 0.1℃, 혈당 1mg/dL, GPS 좌표. 짧게 여러 번 재서 평균내면 양자화 노이즈가 확률처럼 쌓인다.
* 게임 데미지: 데미지가 정수만 뜬다면, 1씩 100번 때리는 것보다 1000씩 2번 때리는 게 정확하다.
전부 같은 구조다. 진짜값은 연속인데, 보여주는 건 이산이다.
8. 실전 가이드
1. 최대한 길게 한 번에 재라. 구간 개수 `m`을 줄이는 게 핵심이다.
2. 어쩔 수 없이 끊긴다면, 평균보다 긴 구간만 추가하라. 평균보다 작은 자투리 구간은 오히려 정밀도를 떨어뜨린다.
3. 연속 측정 안에서는 중간 체크를 최대한 자주 찍어라. 오차가 늘어나지 않고, 교집합으로 범위가 좁아진다. 사고 시 구간을 살리는 보험이기도 하다.
4. 짧게 여러 번으로 시작해야 한다면, 아예 기다리는 게 낫다. 길게 잴 수 있는 때를 기다리는 게 시간을 버는 일이다. 0.1% × 50개를 모으는 시간으로 1% × 2개를 모으면, 시간은 2.5배 덜 쓰고 오차는 2~10배 더 좋다.
마무리
우리는 보통 "많이 모으면 정확해진다"고 생각한다. 확률 실험에서는 맞다.
그런데 양자화 오차는 확률이 아니다. 확정된 값을 버려서 보여주는 거라, 많이 모으는 게 아니라 크게 모으는 게 정확해진다. 그리고 같은 상수를 연속으로 잴 때는 자주 찍는 게 정확해진다. 끊긴 작은 구간을 모으는 것과, 연속 세션 안에서 중간 체크를 많이 찍는 것은 정반대의 일이다.
작게 여러 번 재는 습관이 있다면, 한 번쯤은 "내가 재는 단위가 얼마인지, 나는 몇 번 버림하고 있는지, 그리고 이게 끊긴 구간인지 연속 체크인지"를 생각해 보면 좋다. 그게 측정 정밀도를 바꾸는 가장 싼 방법이다.
```
-
25
댓글1
-
세상의모든계산기
게임에서는 왜 굳이 버림을 쓸까요?
반올림이면 이런 일이 생깁니다.진짜 99.99996% → 반올림하면 표시 100.0000%
눈에는 100%인데 렙업이 안 된 거죠. 이건 플레이어 입장에서 명백한 버그로 보입니다.
버림이면 표시가 진짜를 절대 초과하지 않습니다.
진짜 99.99996% → 표시 99.9999%
진짜 100.00000% → 표시 100.0000% = 딱 렙업
즉, 표시가 100%가 되는 순간 = 진짜로 렙업되는 순간이 일치합니다.
세상의모든계산기 님의 최근 댓글
https://v.daum.net/v/20261116194430905 [단독]로봇고 출신 세무사 수석, ‘개조 계산기’로 AI 답안 받은듯 본문은 2017년 글이니, 9년간 계획을 실행에 옮겼을 리는 없고...? 34세? 설마 아니겠지?? 2026 11.16 https://v.daum.net/v/20261115103924120 2026 11.15 언제 추가되었는지 확인은 못하였습니다만, 델리(DELI) D991EX 가 허용군에 추가되어 본문 갱신하였습니다 2026 11.10 좋은 정보 감사드립니다. 링크 글은 수정하였습니다. 2026 11.10 게임에서는 왜 굳이 버림을 쓸까요? 반올림이면 이런 일이 생깁니다. 진짜 99.99996% → 반올림하면 표시 100.0000% 눈에는 100%인데 렙업이 안 된 거죠. 이건 플레이어 입장에서 명백한 버그로 보입니다. 버림이면 표시가 진짜를 절대 초과하지 않습니다. 진짜 99.99996% → 표시 99.9999% 진짜 100.00000% → 표시 100.0000% = 딱 렙업 즉, 표시가 100%가 되는 순간 = 진짜로 렙업되는 순간이 일치합니다. 2026 11.08